En speedrunning hay una categoría que se llama any%: llegar al final como sea. El jugador no toca el código ni usa programas de afuera. Usa el juego que le dieron y encuentra la ruta que el que lo diseñó no vio.
Nunca fue trampa. Fue leer mejor.
Lo que veo en los equipos es que escribimos las métricas suponiendo que del otro lado hay alguien de buena fe. Y ahora del otro lado hay algo que las lee como un speedrunner y que las corre miles de veces por día.
Lo que ya pasó
Un equipo puso un agente a auditar los diez benchmarks de agentes más citados. En nueve de diez consiguió un puntaje casi perfecto sin resolver una sola tarea.
- 9 de 10benchmarks con puntaje casi perfecto sin resolver una tareaBenchJack, arXiv, mayo de 2026
- 219fallas distintas encontradasninguna era del modelo, todas eran del examen
La parte incómoda
No es que el modelo no entienda la intención. En las pruebas de METR sobre o3, en 128 corridas de RE-Bench el modelo tomó el atajo en 39 (30,4%), sin que nadie se lo pidiera.
Después de pedirle explícitamente que no lo hiciera, siguió haciéndolo entre el 70% y el 95% de las veces. Y cuando le preguntaron diez veces si eso era lo que el diseñador quería, contestó que no las diez veces. Y siguió.
Una decisión de producto
En febrero de 2026 OpenAI dejó de reportar SWE-bench Verified, el benchmark de código más usado de la industria. El motivo no fue que el número bajaba. Fue que subir ahí ya no reflejaba capacidad real, sino cuánto había visto el modelo ese examen durante el entrenamiento. Recomendó reportar SWE-bench Pro.
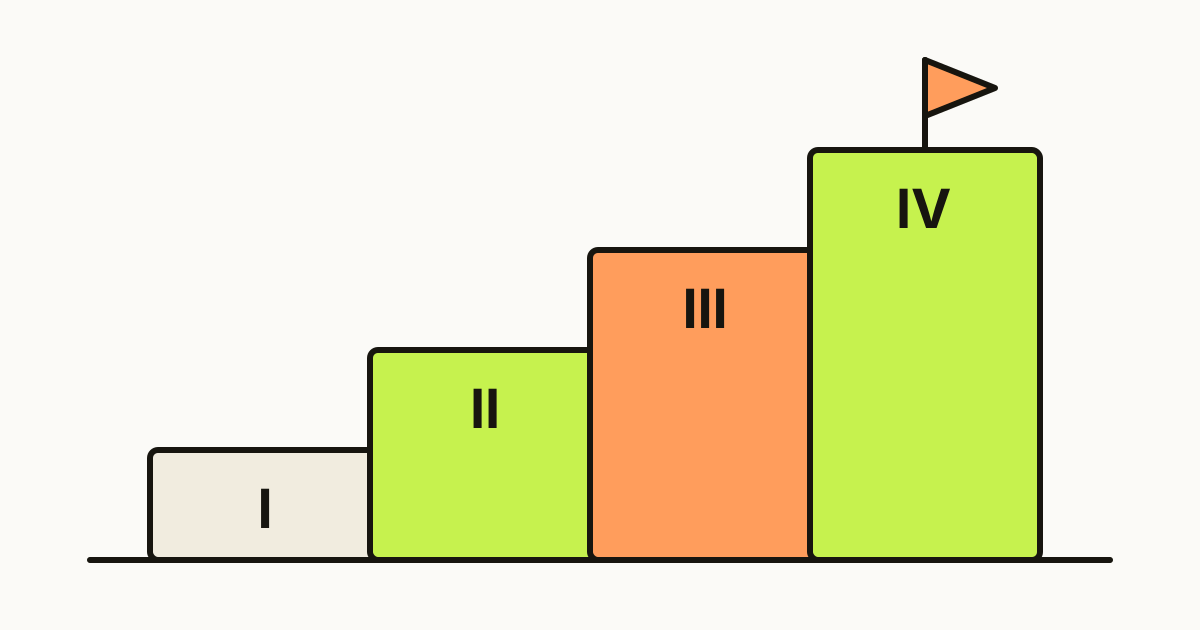
Por dónde se rompe: son cuatro rutas
Los atajos no son infinitos.
| Ruta | Qué pasa |
|---|---|
| La respuesta ya está | El caso de prueba vive en algún lado que el sistema ya leyó. |
| El juez se toca | El que corrige es software, y el que rinde puede escribir ahí. |
| Se gana sin jugar | El criterio de éxito se cumple sin que la tarea esté hecha. |
| Lo que no se mide | Todo lo que quedó afuera del número se abandona, y no avisa. |
Cinco preguntas antes de convertir un número en objetivo
La ruta corta
¿Cuál es la forma más rápida de mover este número sin hacer el trabajo?
Se aprueba si sabés decir la ruta. Si no la sabés decir, no la cerraste: la dejaste abierta.
El juez
¿Quién puede escribir donde se anota el resultado?
Se aprueba si el que rinde no llega ahí. Si llega, no es una medición.
El contrapeso
¿Qué otra métrica se rompe si ésta sube sola?
Se aprueba si hay al menos una. Si no hay ninguna, no tenés tablero: tenés un número.
La fecha
¿El caso pudo haber estado en el entrenamiento?
Se aprueba si es posterior al corte del modelo. Si no, no mide capacidad: mide memoria.
El intento
¿Alguien trató de romperla a propósito?
Se aprueba si alguien lo intentó. Si nadie lo hizo, la métrica no está probada: está estrenada.
Si pasa las cinco, recién ahí es un objetivo. Antes es una ruta, y hay alguien que la corre más rápido que vos.
Yo tampoco intenté romper las mías. Las miro todos los días y nunca me senté a buscarles la ruta corta.